Gemma 4 + FastMCP로 완전 오프라인 프라이빗 MCP 서버 구축하기
Ollama + Gemma 4 + FastMCP로 인터넷 연결 없이 작동하는 완전 오프라인 프라이빗 AI 도구 파이프라인을 구축하는 실전 가이드. 의료·법률·금융처럼 사내 데이터를 외부 클라우드 서버로 보낼 수 없는 보안 환경에서 로컬 LLM 기반 MCP 도구를 안전하게 운영하는 방법.
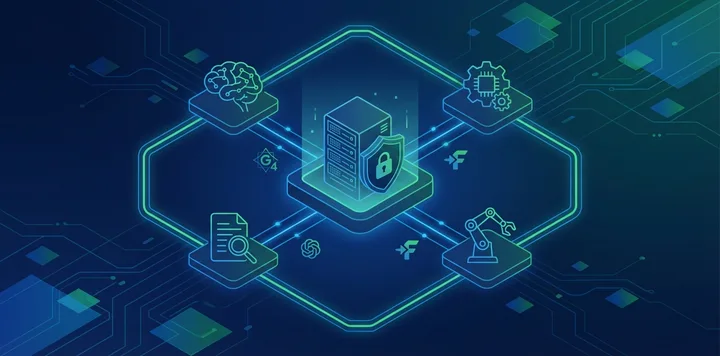
“클라우드 AI를 쓰면 안 되는 환경에서 일한다.” 이 말을 처음 들었을 때 솔직히 와닿지 않았다. 그런데 병원 의무기록을 다루는 팀, 법률 내부 문서를 검토하는 팀, 금융 고객 데이터를 분석하는 팀을 만나보니 생각보다 훨씬 많았다. 이런 팀에게 “Claude나 GPT에 붙여넣기 해보세요”는 애초에 선택지가 아니다.
지난주에 FastMCP로 MCP 서버를 직접 만드는 글을 썼다. 그 글에서 Claude Code를 클라이언트로 연결하는 부분을 다뤘는데, 그 직후 받은 질문이 이것이었다: “Claude 대신 로컬 LLM을 클라이언트로 쓸 수 있을까요?”
이 글은 그 질문에 대한 답이다. Ollama + Gemma 4 + FastMCP로, 인터넷 연결 없이 완전히 오프라인에서 동작하는 AI 도구 파이프라인을 직접 구현해봤다. Ollama로 Gemma 4를 서빙하는 운영 측면은 Ollama + FastAPI 프로덕션 배포 가이드에서 더 자세히 다뤘으니 함께 보면 좋다.
공식 문서 먼저: 이 글에 나오는 도구들의 1차 출처를 정리해둔다. 시작 전에 각 프로젝트의 현재 권장 설정을 확인하는 게 좋다.
- Ollama 공식 사이트: ollama.com
- FastMCP 공식 문서: gofastmcp.com
- Model Context Protocol(MCP) 공식 사양: modelcontextprotocol.io
- Gemma 모델(Google DeepMind): deepmind.google/models/gemma
데이터가 어디로 흐르는지부터 본다
표준 MCP 구조는 이렇다.
[Claude / GPT-4] ←→ [MCP Server] ←→ [실제 도구들]클라우드 LLM이 MCP 클라이언트 역할을 한다. 문제는 이 경우 프롬프트와 컨텍스트가 Anthropic/OpenAI 서버를 거친다는 것이다.
우리가 만들 구조는 다르다.
[사용자 프롬프트]
        |
[Python 오케스트레이터]
   ↙            ↘
[Ollama:11434]   [FastMCP:8000]
(Gemma 4)        (로컬 도구들)
모든 것이 로컬에서 돈다. Ollama가 Gemma 4를 OpenAI 호환 API로 서빙하고, FastMCP가 도구 서버 역할을 하며, Python 오케스트레이터가 둘을 이어준다.
Step 1: Ollama + Gemma 4 설정
Gemma 4 로컬 설치 경험에서 다뤘듯, 설치 자체는 한 줄이다.
ollama pull gemma4여기서는 함수 호출(function calling)이 핵심이다. 그래서 모델이 제대로 로드됐는지 먼저 확인한다.
ollama run gemma4 "다음 JSON을 반환해줘: {\"status\": \"ok\"}"출력이 올바른 JSON이면 준비 완료다. Ollama는 기본적으로 http://localhost:11434에서 OpenAI 호환 API를 서빙한다.
# Ollama API 동작 확인
curl http://localhost:11434/v1/models
Step 2: FastMCP 서버 (도구 제공자)
로컬 파일 시스템을 읽고, 디렉토리를 나열하는 도구 서버를 만든다. 실제 업무에서는 사내 DB 쿼리, 사내 API 호출 등으로 바꿀 수 있다.
# local_tools_server.py
from fastmcp import FastMCP
import os

mcp = FastMCP("local-tools")

@mcp.tool()
def read_file(path: str) -> str:
    """지정한 경로의 파일 내용을 읽어 반환한다."""
    with open(path, "r", encoding="utf-8") as f:
        return f.read()

@mcp.tool()
def list_directory(path: str = ".") -> list[str]:
    """디렉토리의 파일 목록을 반환한다."""
    return os.listdir(path)

@mcp.tool()
def write_summary(path: str, content: str) -> str:
    """요약 내용을 파일로 저장한다."""
    summary_path = path.replace(".txt", "_summary.txt")
    with open(summary_path, "w", encoding="utf-8") as f:
        f.write(content)
    return f"저장 완료: {summary_path}"

if __name__ == "__main__":
    mcp.run(transport="streamable-http", host="127.0.0.1", port=8000)
pip install fastmcp uvicorn
python local_tools_server.py서버가 http://127.0.0.1:8000에서 기동된다.
Step 3: 오케스트레이터 구현
이 부분이 핵심이다. Gemma 4는 MCP 프로토콜을 직접 이해하지 못한다. 오케스트레이터가:
- FastMCP에서 사용 가능한 도구 목록을 가져와
- OpenAI function calling 형식으로 변환해
- Gemma 4에 전달하고
- Gemma 4가 툴 콜을 요청하면 FastMCP를 실행한 뒤 결과를 다시 전달한다
# orchestrator.py
import json
import requests
from openai import OpenAI

# Ollama OpenAI 호환 클라이언트
llm = OpenAI(
    base_url="http://localhost:11434/v1",
    api_key="ollama",  # Ollama는 키 불필요, 형식만 맞추면 됨
)

MCP_SERVER = "http://127.0.0.1:8000"

def get_mcp_tools() -> list[dict]:
    """FastMCP에서 사용 가능한 도구 목록을 가져와 OpenAI 형식으로 변환."""
    resp = requests.get(f"{MCP_SERVER}/tools")
    tools = resp.json().get("tools", [])
    return [
        {
            "type": "function",
            "function": {
                "name": t["name"],
                "description": t.get("description", ""),
                "parameters": t.get("inputSchema", {"type": "object", "properties": {}}),
            },
        }
        for t in tools
    ]

def call_mcp_tool(name: str, args: dict) -> str:
    """FastMCP 서버에 도구 실행을 요청하고 결과를 반환."""
    resp = requests.post(
        f"{MCP_SERVER}/tools/{name}",
        json={"arguments": args},
    )
    result = resp.json()
    return json.dumps(result.get("content", [{"text": str(result)}]), ensure_ascii=False)

def run(user_prompt: str) -> str:
    tools = get_mcp_tools()
    messages = [
        {"role": "system", "content": "당신은 도움이 되는 AI입니다. 필요한 경우 제공된 도구를 사용하세요."},
        {"role": "user", "content": user_prompt},
    ]

    while True:
        resp = llm.chat.completions.create(
            model="gemma4",
            messages=messages,
            tools=tools,
            tool_choice="auto",
        )
        msg = resp.choices[0].message

        if not msg.tool_calls:
            return msg.content  # 최종 답변

        # 툴 콜 처리
        messages.append(msg)
        for tc in msg.tool_calls:
            args = json.loads(tc.function.arguments)
            result = call_mcp_tool(tc.function.name, args)
            messages.append({
                "role": "tool",
                "tool_call_id": tc.id,
                "content": result,
            })

if __name__ == "__main__":
    answer = run("현재 디렉토리의 파일 목록을 알려줘")
    print(answer)
실제로 돌려봤더니
python orchestrator.pyGemma 4가 list_directory 도구를 호출하고, FastMCP 서버가 결과를 반환하고, Gemma 4가 그걸 정리해서 답변한다. 모든 데이터가 내 맥북 안에서만 움직인다.
조금 더 복잡한 요청을 해봤다.
answer = run("README.md 파일을 읽고 핵심 내용을 3줄로 요약해줘")Gemma 4는 list_directory → read_file("README.md") 순서로 호출했다. 두 번의 툴 콜을 거쳐 최종 요약이 나왔다. 다만 느렸다. 내 M2 맥북에서 약 12초. 클라우드 API와 비교하면 답답한 속도지만, 데이터가 맥북 밖으로 한 번도 나가지 않았다는 게 핵심이다.
솔직한 한계
써보면서 느낀 것들이다.
툴 콜링 신뢰도가 낮다. Gemma 4는 함수 호출을 어느 정도 지원하지만, 인자를 잘못 넣거나 없는 도구를 호출하는 경우가 간혹 있다. Claude나 GPT-4o 대비 안정성이 떨어진다. 이를 보완하려면 오케스트레이터에 재시도 로직과 파라미터 검증을 추가해야 한다.
멀티스텝에서 맥락을 잃는다. 3〜4번 이상 툴 콜이 이어지면 Gemma 4가 원래 목표를 잊는 경우가 있었다. 시스템 프롬프트에 명시적으로 “최종 목표: [X]“를 박아 넣는 게 도움이 됐다.
속도. 개인 맥북이면 5〜15초, 응답 길이에 따라 더 걸린다. 실시간 인터랙션에는 적합하지 않다. 배치 처리, 백그라운드 작업에 쓰는 게 현실적이다.
언제 이 구조를 써야 하는가
| 상황 | 선택 |
|---|---|
| 개인 데이터, 사내 문서, 규제 데이터 | ✅ 이 구조 |
| 빠른 응답이 필요한 인터랙티브 UI | ❌ 클라우드 API |
| 인터넷 연결이 없는 에어갭 환경 | ✅ 이 구조 |
| 복잡한 멀티스텝 에이전트 워크플로우 | ⚠️ 제한적으로 가능 |
| 비용 최소화 (트래픽 없음) | ✅ 이 구조 |
개인적으로는 이 구조를 “AI 기능이 있는 로컬 스크립트”의 업그레이드로 본다. 셸 스크립트나 Python 스크립트로 하던 파일 조작, 데이터 변환 작업에 자연어 인터페이스를 붙이는 용도다. 완전한 에이전트 시스템이라기보다는, 자동화 스크립트의 다음 단계에 가깝다.
언제 쓰고, 언제 피할지
위 표는 빠른 판단용이고, 실제로 도입을 고민할 때는 조금 더 구체적인 기준이 필요하다. 몇 달 돌려보며 정리한 판단선이다.
로컬 LLM + MCP가 잘 맞는 경우
- 데이터가 절대 밖으로 나가면 안 되는 환경. 의무기록, 법률 내부 문서, 금융 고객 정보처럼 컴플라이언스가 외부 전송을 막는 경우다. 이때는 클라우드 API가 더 똑똑해도 애초에 선택지가 아니다. 에어갭 환경이라면 더 명확하다.
- 배치성 작업. 야간에 사내 문서를 분류하거나, 로그를 요약하거나, 파일을 변환하는 일처럼 사람이 응답을 기다리지 않는 작업이다. 5〜15초의 지연이 문제가 되지 않는다.
- 호출량이 많아 비용이 부담되는 반복 작업. 같은 종류의 처리를 하루에 수천 번 돌린다면, 토큰 단가 대신 고정된 로컬 하드웨어 비용으로 바꾸는 게 유리하다.
- 도구 수가 적고 흐름이 단순한 경우. 한두 번의 툴 콜로 끝나는 작업에서 Gemma 4의 함수 호출은 충분히 쓸 만하다.
피하는 게 나은 경우
- 실시간 인터랙티브 UI. 사용자가 화면 앞에서 답을 기다리는 챗봇이나 검색창이라면, 이 지연은 그대로 이탈로 이어진다. 클라우드 API를 쓰는 편이 낫다.
- 복잡한 멀티스텝 에이전트. 5〜6단계 이상 툴 콜이 이어지는 워크플로우에서는 Gemma 4가 목표를 잃거나 인자를 틀리는 빈도가 올라간다. 안정적인 함수 호출이 필요하면 Claude나 GPT-4o가 여전히 앞선다.
- 데이터 민감도가 낮은 일반 작업. 외부로 보내도 문제없는 데이터라면, 굳이 로컬 하드웨어와 운영 부담을 떠안을 이유가 없다. 클라우드 API의 품질과 속도가 대체로 더 낫다.
- 최신·최고 추론 품질이 핵심 지표인 경우. 로컬 오픈 모델은 빠르게 좋아지고 있지만, 프런티어 모델과의 추론 격차는 아직 존재한다.
판단의 핵심은 결국 “이 데이터를 밖으로 내보낼 수 있는가”와 “이 작업이 사람을 기다리게 하는가” 두 축이다. 둘 다 까다로운 쪽이면 이 구조가, 둘 다 여유로운 쪽이면 클라우드가 맞다.
다음 단계
더 발전시키고 싶다면:
- 모델 교체: Gemma 4 대신 Qwen3-7B, Mistral Small 등 더 강력한 함수 호출 지원 모델로 교체
- 도구 확장: 사내 DB 연결, REST API 래퍼, 파일 변환 도구 추가
- 팀 공유: MCP Gateway를 앞단에 놓고 여러 사람이 같은 로컬 서버를 사용
이 파이프라인이 프로덕션으로 갈 때는, MCP 보안 이슈도 체크하길 권한다. 로컬이라도 툴 인젝션, 과도한 권한 같은 MCP 특유의 위험은 그대로 존재한다.
Python 오케스트레이터 대신 TypeScript로 MCP 클라이언트를 구현하고 싶다면 @modelcontextprotocol/sdk로 TypeScript MCP 클라이언트를 만드는 방법을 참고하면 된다. 로컬 모델에서 구조화된 JSON 출력을 안정적으로 받는 기법은 Ollama structured outputs + Pydantic 가이드에서 따로 다뤘다.
코드는 모두 위에 있다. 설치 의존성은 pip install fastmcp uvicorn openai requests 하나면 끝이다. 돌려보고 막히는 부분이 있으면 각 스텝별로 따로 테스트해보는 게 빠르다.
자주 묻는 질문
왜 클라우드 AI 대신 로컬 LLM + MCP 구조를 쓰나요?
Gemma 4가 MCP 프로토콜을 직접 이해하나요?
로컬에서 돌리면 응답 속도가 어느 정도인가요?
이 구조의 한계는 무엇인가요?
다른 언어로 읽기
- 🇰🇷 한국어 (현재 페이지)
- 🇯🇵 日本語
- 🇺🇸 English
- 🇨🇳 中文
관련 글
-
FastMCP 3.x로 Python MCP 서버 30분 만에 만들기 — @tool 데코레이터 하나면 충분하다
fastmcp 주제를 한 단계 더 깊이 파고드는 글입니다.
-
Ollama + FastAPI 로컬 LLM API 서버 구축 — Docker 프로덕션 배포 가이드
ollama를 실제로 다뤄본 경험이 이어지는 글입니다.
-
TypeScript로 MCP 서버 만들기 — @modelcontextprotocol/sdk 실전 튜토리얼
같은 MCP 흐름에서 함께 읽으면 좋습니다.